KWIC 索引:把一个词的每次出现排在一起看
政策文件里的【更新】说的是拆掉重建还是保留修缮?把这个词的每次出现连同前后文排成一列,就看得出来。这篇讲这种索引从哪来,各学科怎么用,想深入该读哪几篇论文。
假设你在研究城市更新政策,手上有三十多份各地的政策文件。【更新】这个词在里面出现了几百次,可它在不同文件里说的未必是同一件事,有的地方指拆掉重建,有的地方指保留修缮。词频只告诉你它出现了多少次。
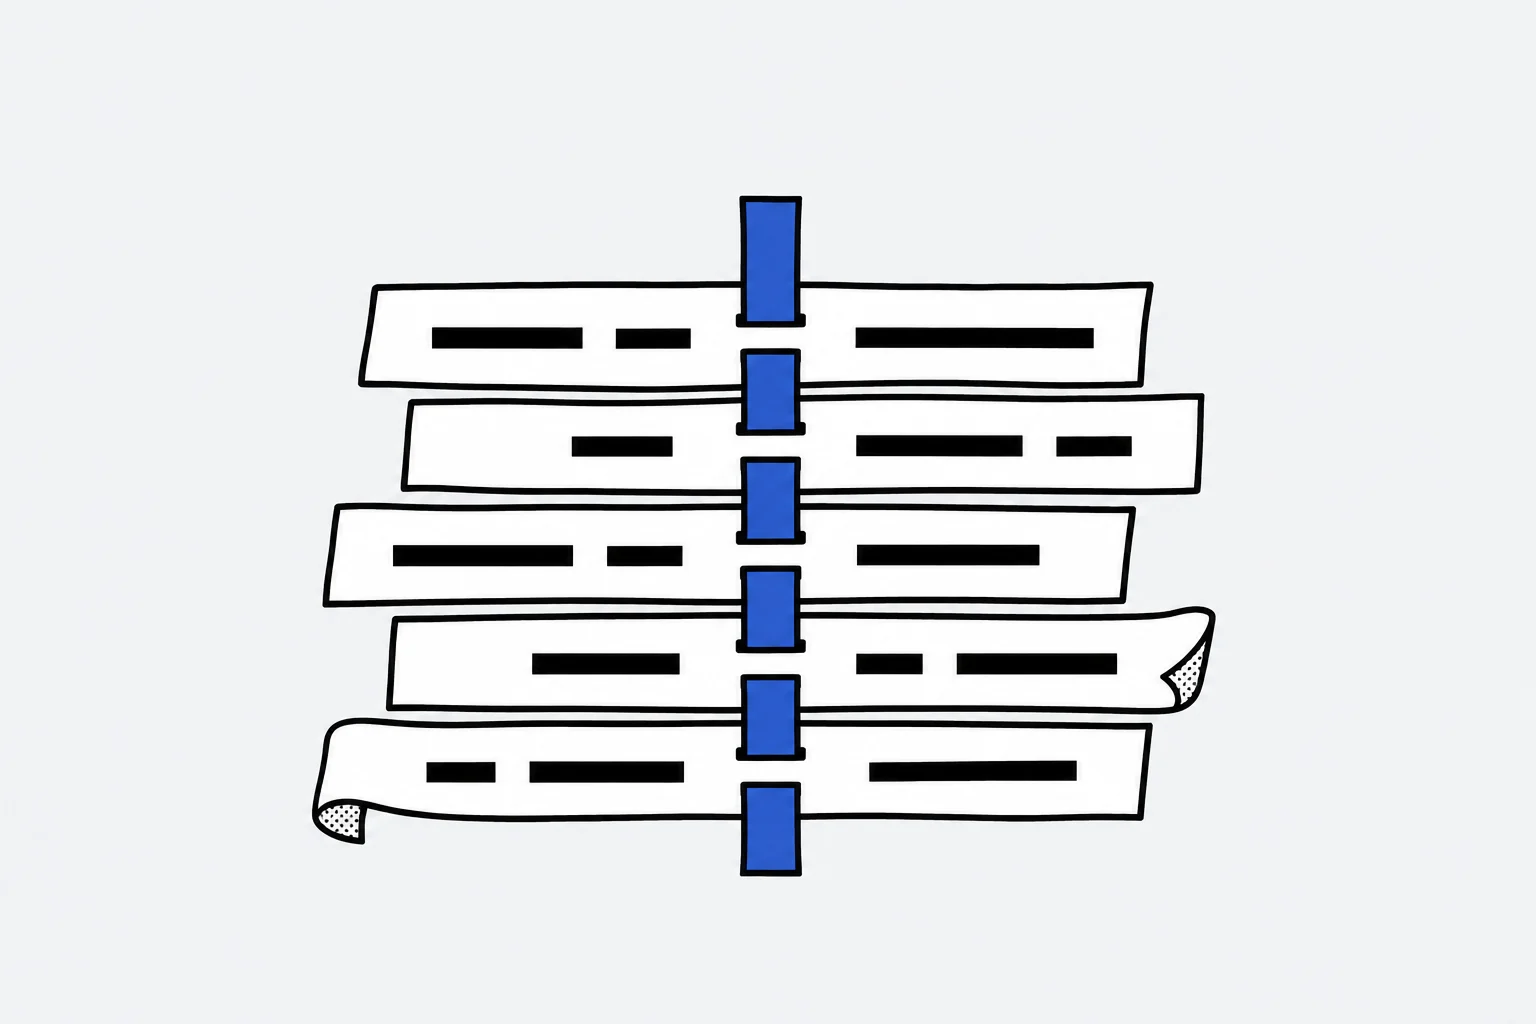
KWIC 索引(keyword in context,把关键词放在上下文里看)把这个词的每一次出现都找出来,一次占一行,关键词摆在正中,左右各带一小段原文,上下对齐。下面是个示意。
      推进老旧小区  更新  改造,完善社区服务设施
  严格控制大拆大建,  更新  以保留修缮为主
    采取拆除重建方式  更新  的片区,应当先行评估
几百行这样排下来,顺着中间那一列往下看,【更新】前后常跟着哪些词、分成哪几种用法,比一篇篇翻文件清楚得多。这样的清单还有个更老的名字,叫语词索引(concordance)。
它背后的想法是,一个词是什么意思、带着什么态度,要看它身边的词。只看一处看不出规律,把所有出处摆在一起才看得出。
这种索引是怎么交给机器做的
语词索引原先靠人一条条抄出来,最早把它交给机器的是一位耶稣会神父。Roberto Busa 从 1946 年起着手给托马斯·阿奎那的全部著作编索引。1949 年,IBM 的老沃森(Thomas J. Watson, Sr.)派了一名员工专门支持这项工作,1951 年 Busa 印出了第一份由机器生成的语词索引样本。这项工程最后成书 56 卷,叫 Index Thomisticus(Winter,1999)。此后做这类索引的人多了起来,Burton 在 1981 到 1982 年连写四篇文章回顾自动语词索引的历史,第一篇讲的就是五十年代(Burton,1981)。
KWIC 这个名字出自 Luhn 1960 年的一篇文章。文章关心的是新出的科技文献怎样尽快让人查到。Luhn 把索引分成两种,一种给新文献用,一种给旧文献用,查新文献的人愿意拿精确换及时。给新文献用的,文章提议做成把关键词放在上下文里的索引,这种索引可以完全由机器生成,所以跟得上文献出版的速度(Luhn,1960)。
再往后,语言学家拿它来研究语言本身。把大量真实的文本收在一起,叫语料库,在语料库里查一个词的全部用例,是语料库语言学的基本功。Sinclair 1991 年的一本书,书名就是并排的三个词,Corpus, Concordance, Collocation,也就是语料库、语词索引和搭配(见 Wong 的书评)。
查索引的软件也到了普通人手里。Anthony 2005 年介绍了自己写的 AntConc。这是一个免费的语料分析工具,能在多种系统上跑,本来是给写作课堂用的,里面有语词索引,有词频和关键词的统计,还能画出一个词在文本里的分布(Anthony,2005)。Kilgarriff 等人 2014 年介绍的 Sketch Engine 是词典编纂界常用的语料工具,核心功能里有语词索引,网站上备着许多现成的语料库(Kilgarriff 等,2014)。
这些工具还进了外语课堂。把语料库语言学的工具和办法用到外语学习上,叫数据驱动学习(data-driven learning)。Boulton 和 Cobb 2017 年汇总了 64 项研究里的 88 个样本,发现这种学法的总体效果量(衡量差别有多大的指标)很大,和对照组比是 0.95,和学习者自己学之前比是 1.50。他们同时指出,学到的东西能保持多久,还缺研究(Boulton 与 Cobb,2017)。
| 年份 | 谁 | 留下了什么 |
|---|---|---|
| 1951 | Busa | 第一份由机器生成的语词索引样本 |
| 1960 | Luhn | KWIC 这个名字,和完全由机器生成的文献索引 |
| 1991 | Sinclair | 一本以语料库、语词索引和搭配为题的书 |
| 2005 | Anthony | 免费的语料分析工具 AntConc |
| 2014 | Kilgarriff 等 | 带现成语料库的 Sketch Engine |
| 2017 | Boulton 与 Cobb | 用语料工具学外语的效果汇总 |
现在谁在用它读材料
用得最多的是研究新闻话语的人。Baker 等人 2008 年分析了一个 1.4 亿词的英国新闻语料,报道的对象是难民、寻求庇护者和各类移民。他们说,搭配分析和语词索引分析帮他们归纳出这些人群常被怎样描写,也把研究者引到有代表性的文章上去做细读(Baker 等,2008)。其中两位作者同年的另一篇文章分析的也是 1.4 亿词的英国报刊语料,文章发表在 1996 到 2005 年间。里面对难民和寻求庇护者的描写大多是负面的,报纸上还出现了【非法难民】这种说不通的叫法(Gabrielatos 与 Baker,2008)。
城市研究里,Terkper 和 Baddianaah 2024 年考察加纳报纸怎样报道首都阿克拉年年发生的内涝。他们用 86602 词的洪水新闻对照 422436 词的参照语料,做了关键词分析和搭配分析,也逐行读了索引行。报道里的洪水常和【问题】【损失】【死亡】这些词连在一起。专家认为主因是排水渠淤积,报纸上常说的原因却是水沟堵塞(Terkper 与 Baddianaah,2024)。
旅游研究用它看游客笔下的目的地。Franceschi 2021 年收集了一批外国人写的中国旅行和生活博客,在 Sketch Engine 里分析关键词和搭配,再抽出索引行做内容分析。结果是,游客对中国和中国人的印象总体是正面的,描写时却常用相互矛盾的说法。游客寻找的是有本真感的东西,比如历史遗迹(Franceschi,2021)。
政策文本也有人这样读。Meng 和 Yu 2016 年比较了 2013 年的内地政府工作报告和香港施政报告,用索引软件生成词频表和词语搭配的型式,重点看第一人称复数代词的用法有什么不同(Meng 与 Yu,2016)。
想深入可以读这几篇
- Luhn(1960)Key word-in-context index for technical literature (KWIC index),KWIC 的出处,讲为什么新文献需要一种机器就能做的索引。
- Winter(1999)Roberto Busa, S.J., and the Invention of the Machine-Generated Concordance,讲 Busa 怎样在没有现成机器的年代做出第一份机器索引,全文可以免费读。
- Baker 等(2008)A useful methodological synergy? Combining critical discourse analysis and corpus linguistics to examine discourses of refugees and asylum seekers in the UK press,把索引行和细读结合起来做话语研究,这篇给了一套做法。
- Anthony(2005)AntConc: design and development of a freeware corpus analysis toolkit for the technical writing classroom,逐个介绍 AntConc 里的工具,读完知道一个索引软件该有什么。
- McEnery 与 Hardie(2012)Corpus Linguistics: Method, Theory and Practice,语料库语言学的教材。
- Boulton 与 Cobb(2017)Corpus Use in Language Learning: A Meta-Analysis,想把语料工具用到外语教学里,先看这篇的汇总。
TATOOLS 里的 KWIC 索引
TATOOLS 的【KWIC关键词上下文索引】做的就是这种索引。把政策文件、访谈稿或新闻报道交给它,再给出你关心的词,它把每一次出现按左侧上下文、关键词、右侧上下文三栏对齐排好,并注明在哪份文件的第几行。关键词也可以让它从材料里的高频词中挑。
报告里还有每个关键词的命中次数和每千字的命中密度,命中位置在全文里的分布,以及哪两个关键词常出现在同一行。