教程
文本分析、数据分析和图像分析里常用的技术:各自从哪里来,用在哪些研究里,有哪些论文可读。
清洗与整理
文本规范化:写法不统一,分析结果会差多少
【东门】和【東門】、半角的 3 和全角的 3,计算机都当成不同的字。这篇讲研究者怎样量出写法不一让词性标注、句法分析和翻译各差多少,统一以后找回多少,什么时候统一反而抹掉了要研究的东西。
标点纠正:标点不对,后面的分析会错在哪
中英文句号混着打,叹号连成一串,一个逗号句拖到底,切句和句长会跟着错,逐句的情感判断也会偏。这篇讲研究者怎样发现标点牵动分词、句法和情感打分,机器怎样检查和改正标点,标点什么时候本身就是数据。
标点恢复:没有标点,后面的分析会错在哪
语音转写稿和古籍常常一个标点也没有,切不出句子,后面按句子做的分析都受牵连,人读着也吃力。这篇讲研究者怎样量出句法分析、信息抽取和翻译各掉多少,补上标点能找回多少,机器现在补得多准。
停用词表:删少了满是套话,删多了丢掉要看的词
通用停用词表删不掉一个领域的套话,换一张现成的表,又可能把否定词和有实义的词一起删掉。这篇讲研究者怎样量出删多删少让检索、分类和主题模型差了多少,照自己的材料编表能挽回多少,什么时候删了也白删。
文本脱敏:分析前先移除隐私信息
访谈稿里夹着手机号和身份证号,交出去之前得先找出来换掉。这篇讲按格式找和让模型学这两条路怎么来的,号码换掉以后人为什么还可能被认出来,法律怎样区分去标识化和匿名化,想深入该读哪几篇。
避免垃圾进垃圾出: 这语料质量值不值得拿来分析
留言里满是【同上】,同一封信贴了几百遍,这样的材料能直接拿去建模吗?这篇讲分析之前怎样给语料做体检,规模、句长、重复率和词汇丰富度各说明什么,为什么要给数据集写一份说明,想深入该读哪几篇。
文本简化:把难读的文字改好读,意思不变
长句和难词会把读者挡在门外。文本简化把文字改得好读,同时保住原意。这篇讲它怎样从替程序拆长句走到替读者改写,改得好不好怎么评,各领域怎么用,想深入该读哪几篇论文。
情感与情绪
情感词典法:数一数褒贬词,判断文字的态度
一张标好褒贬的词表,加上处理【不】【很】这类词的几条规则,就能给成千上万条评论打分。这篇讲词表怎么来,否定词和程度词怎么算,这个办法长在哪、短在哪,各学科怎么用,想深入该读哪几篇论文。
情感分类:判断文字是积极、消极还是中性
两万条游客评论,哪些在夸,哪些在抱怨?情感分类读完整句,给出积极、消极或中性,再附上几成把握。这篇讲它怎样学会看否定和反话,换一类材料为什么会判错,把握和占比该怎么读,各学科怎么用它,想深入该读哪几篇。
效价、唤醒度、支配度:情感分析不应只有积极消极还有程度
同样是不满,有的人在气头上,有的人觉得无力。这篇讲效价、唤醒度和支配度三个维度各量什么,它们怎样从心理学实验变成几万个词的评分表和模型,各学科怎么用,想深入该读哪几篇论文。
情感曲线:看清从头到尾情绪几起几落
一份口述、一篇游记、一部小说,情绪在哪里跌到谷底,后来回升没有?这篇讲怎样把这种起落画成一条线,曲线怎么抹平,六种故事形状的说法从哪来,招来过哪些批评,想深入该读哪几篇论文。
关键词与词表
虚高频词:哪些高频词在哪儿都常见
【我们】【工作】【没有】排在词频表前面,是这批材料在谈它们,还是这些词在哪儿都多?这篇讲怎样拿通用语料当尺子量一量,这个办法从哪来,各学科怎么用,想深入该读哪几篇论文。
关键短语抽取:哪些整串说法最能代表一份材料
【老旧小区改造】拆成三个词,原来的意思就散了。这篇讲关键短语抽取怎样先圈候选再排先后,有监督和无监督两条路怎么走,结果怎么评,各学科怎么用,想深入该读哪几篇论文。
领域术语抽取:一个领域常用哪些多词说法
【旅游目的地形象】一分词就碎成三个词。这篇讲怎样从一批同领域的材料里自动找出术语,C-value 怎样处理短术语嵌在长术语里的情况,这套办法从哪来,各学科怎么用,想深入该读哪几篇论文。
信息抽取
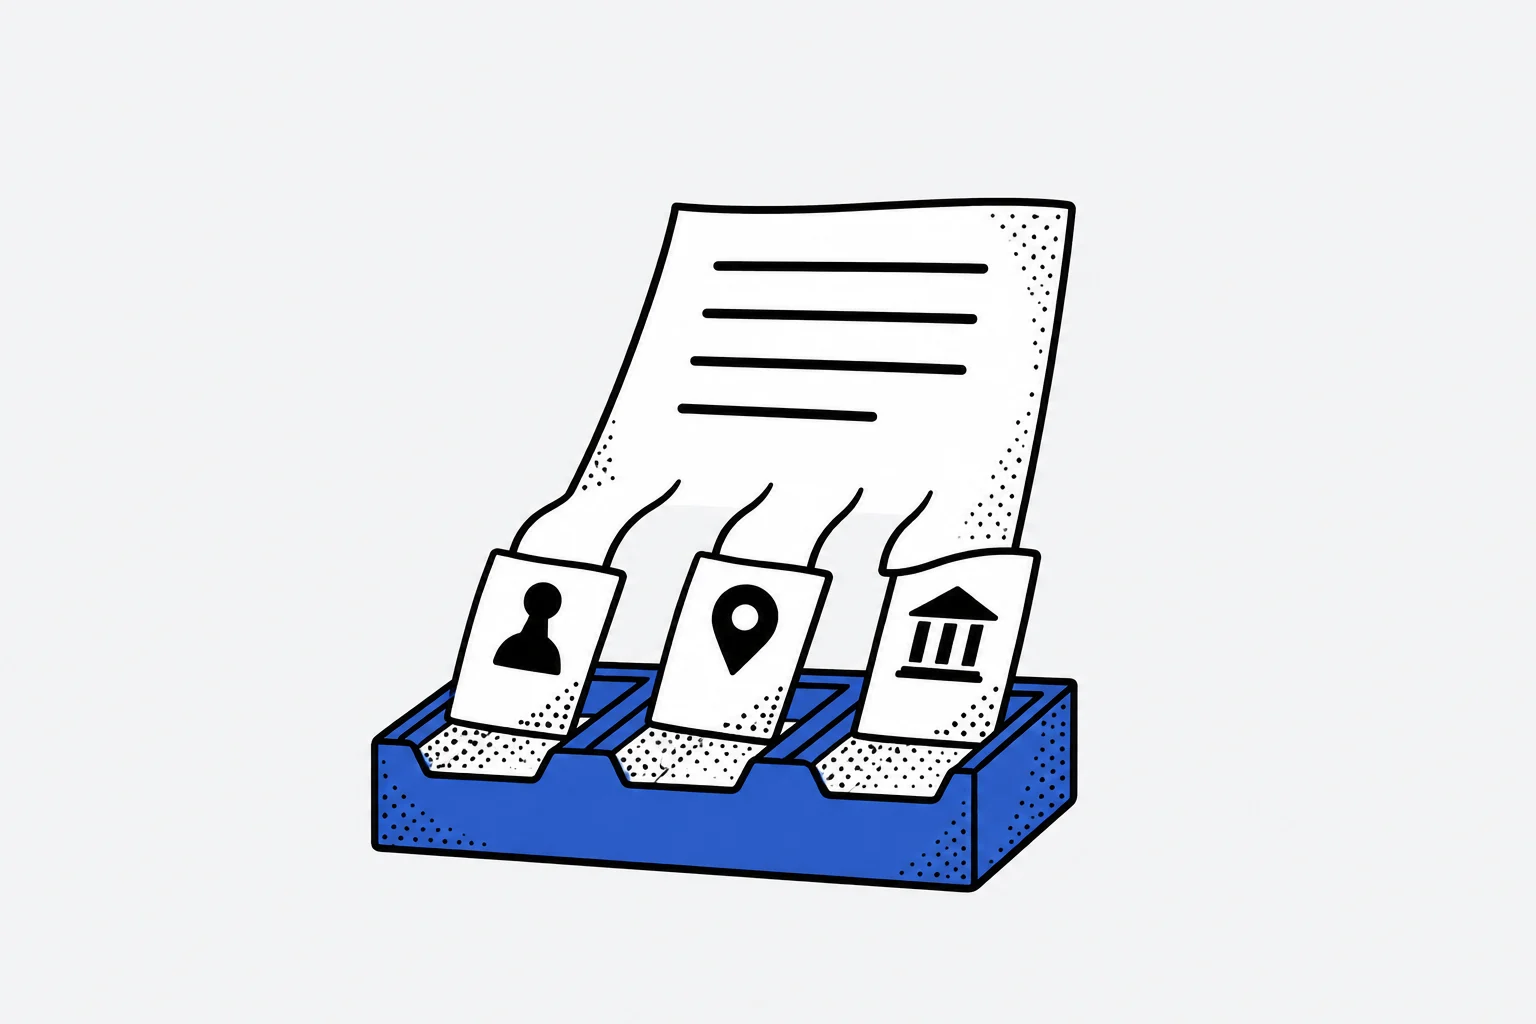
命名实体识别:文中提到了哪些人、哪些地方、哪些机构
一批新闻或访谈里提到了哪些人、哪些地方、哪些单位?命名实体识别把这些专名找出来并归类。这篇讲这项任务怎样在评测会议上定型,怎样从手写规则走到神经网络,中文难在哪里,各学科拿它做什么。
从文本构建知识图谱:文字里谁和谁有什么关系
一批政策文件或访谈里,哪个部门管哪件事,谁和谁有来往?知识图谱把这些关系抽成一张由点和箭头组成的图。这篇讲关系怎样从句子里抽出来,同一个东西的几种叫法怎样并到一起,这门技术怎么发展来的,有哪些研究在用,想深入读哪几篇。
抽取式摘要:从原文中找出最能代表全文的句子
不另写一个字,只从原文里挑出最有代表性的句子拼成摘要。这篇讲句子怎样打分和排序,它和让机器另写的生成式摘要差在哪,好坏怎么评,各学科怎么用,想深入该读哪几篇。
主题与聚类
LDA 主题模型:一大批文档都在谈些什么
几百份规划、几万条游客点评读不过来时,LDA 把常一起出现的词归成主题,再算出每篇文档里各主题占多少。这篇讲它的想法和来历,社会科学怎么用、容易错在哪,以及该读哪几篇论文。
主题模型评估:主题数定几个才合适
跑主题模型之前要先填一个主题数。这篇讲困惑度和主题一致性各在量什么,为什么困惑度低的模型主题未必好懂,这些指标从哪来,规划、旅游和政策研究怎样定这个数,以及该读哪几篇论文。
BERTopic:按意思把一批短文字聚成主题
几万条游客短评,每条一两句话,用词各不相同,怎样看出大家在谈哪几件事?这篇讲 BERTopic 怎样先按意思分组、再找代表词,它和 LDA 有什么不同,从哪来,研究里怎么用,该读哪几篇论文。
LSA 潜在语义分析:用词不同的文字怎样靠到一起
有人写【绿地】,有人写【草坪】,按字面去搜会漏掉一批。这篇讲 LSA 怎样把词和文档的大表压成几个潜在维度,它从哪来,在心理学和教育测评里做过什么,后来被什么接替。
文本聚类:没有分类表,怎样让文本按内容分组
一大批留言、评论或访谈,还没有分类表,能不能先让程序按内容相近分成几组?这篇讲文本怎样变成能比远近的数,层次聚类和 k-means 怎样分组,分出的组怎样起名和验收,以及这套办法的来历、用处和值得读的论文。
词语关系与检索
KWIC 索引:把一个词的每次出现排在一起看
政策文件里的【更新】说的是拆掉重建还是保留修缮?把这个词的每次出现连同前后文排成一列,就看得出来。这篇讲这种索引从哪来,各学科怎么用,想深入该读哪几篇论文。
词语搭配与共现:两个词总是一起出现,背后藏着什么可用的规律?
【古镇】后面总跟着【夜景】,是固定说法,还是两个词碰巧挨着?这篇讲共现怎么数,互信息、T 值和对数似然比各偏向什么样的搭配,这套办法从哪来,各学科怎么用,想深入该读哪几篇论文。
内容分析的词典法:不靠聚类,怎么知道材料谈了什么?答案在词典命中里
先定好几个概念,给每个概念配一组词,再数每段材料里各个概念出现了几次。这篇讲这个办法从哪来,词典怎么编、怎么检验,数出来的表怎么读,各学科怎么用,想深入该读哪几篇论文。
语料检索:换了说法的同义表达,检索时怎么归到一起?
在一批文档里按一句话找段落,按字面找会漏掉换了说法的段落,按意思找又会漏掉另一些。这篇讲两路检索各自的长短,两份结果怎样合并,为什么最后还要再排一遍,以及想深入该读哪几篇论文。
句子的语义相似度:用词不同,怎样看出意思相近
两句话没有一个共同的词,说的却是一回事;只差一个【不】字,意思又正相反。这篇讲程序怎样从数共同的词走到比较句向量,这个分数能信到什么程度,研究里怎么用,想深入该读哪几篇。
句法与文体
词性标注:这个词在这里是名词还是动词
【规划】在这一句里是名词,换一句成了动词。这篇讲词性标注:类别的清单是怎么定下来的,程序怎样在一词多类里选对,标完以后研究者拿各类词的多少做什么,想深入该读哪几篇论文。
依存句法分析:词与词的支配关系是什么? 找主干、理清修饰、抽取语义关系
一句话里的词一个依附一个,连起来是一棵树。这篇讲这棵树怎么看,分析器怎样自动把它画出来,树的深度和依存距离为什么能衡量句子有多难读,各学科拿它做什么研究。
句法搭配与句式模式:整批材料里谁对谁做了什么
【政府动员居民】和【居民动员邻里】,按挨得近不近数搭配是分不开的。这篇讲依存分析之后,怎样把主谓宾、动宾和修饰关系整批数出来,这个办法从哪来,社会科学拿它研究什么,想深入该读哪几篇论文。
话语标记与衔接:数一数因为和但是能看出什么
【因为】【但是】【不仅如此】把句子接起来,自己却不带内容。这篇讲语言学怎样界定和归类这些词,计算机怎样数它们,数出来的结果能说明什么、说明不了什么,各学科怎么用,想深入该读哪几篇论文。
词汇多样性:用词丰富还是翻来覆去那几个
不同的词数除以总词数,看上去就能量出用词丰富不丰富,可文字越长这个比值越小。这篇讲 TTR 怎样被长度骗,MTLD、MATTR 这些指标怎样补救,各学科拿它研究什么,想深入该读哪几篇。
词汇增长曲线:文字越长,新词为什么越来越少
一批留言越读越长,没见过的词却出现得越来越慢。这篇讲描述这条曲线的 Heaps 定律,它和 Zipf 定律是什么关系,拟合出来的指数说明什么,各学科拿它研究什么,想深入该读哪几篇。
词汇分级:这段文字适合什么水平的读者
景区导览词、政策说明写给外国读者,里面的词他们认不认得?这篇讲怎样把文字里的词逐个对到分级词表上,分级词表是怎么编出来的,认得多少词才读得懂,想深入该读哪几篇论文。
信息熵与词汇密度:一段话的信息量能不能算出来
同一句话重复十遍,字数多了,信息并没有多。这篇讲香农的熵怎样把信息量算成一个数,词汇密度怎样换个角度量,这两个数能说明什么、说明不了什么,各学科怎么用,想深入该读哪几篇论文。
文体测量:两篇文章是不是一个文风
每个人写东西都带着几样自己不太留意的小习惯,比如【的】【了】【而】用得多还是少。这篇讲文体测量怎样把这些习惯数成数字来比,它怎样从一桩作者之争走到今天,各学科拿它研究什么,想深入该读哪几篇论文。
语体的多维度分析:各类文字的写法差在哪几方面
规划文本、游记和访谈稿,写法一读就不同。这篇讲多维度分析怎样一次数几十项语言特征,找出总是一起出现的几组,把差别归成几个维度;它怎样从英语走到别的语言和网上的文字,各学科拿它研究什么,想深入该读哪几篇论文。
AI生成文本检测:文字是人写的还是哪个大模型写的
判断一段文字出自人手还是模型,有三条路:看用词好不好猜,训练分类器,在生成时埋下水印。这篇讲它们怎样走到今天,各自在哪里判错,研究里怎么用,想深入该读哪几篇论文。
数据概览与基础统计
主成分分析:几十个指标怎样压成几个综合指标
几十个互相牵连的城市指标或问卷题目,怎样压成少数几个综合指标又不丢太多信息?这篇讲主成分的想法和载荷的读法,留几个成分怎么定,KMO 和 Bartlett 检验做什么,它从哪来,谁在用,该读哪几篇。
K-Means 聚类:按指标远近把样本分成 K 类
几十个县、几百份游客问卷,怎样按各项指标的相近程度分成几类?这篇讲 K-Means 怎样一步步挪中心,为什么要先标准化,K 取几怎么判断,分出的类怎样画像,以及它的来历、用处和值得读的论文。
没有找到