LDA 主题模型:一大批文档都在谈些什么
几百份规划、几万条游客点评读不过来时,LDA 把常一起出现的词归成主题,再算出每篇文档里各主题占多少。这篇讲它的想法和来历,社会科学怎么用、容易错在哪,以及该读哪几篇论文。
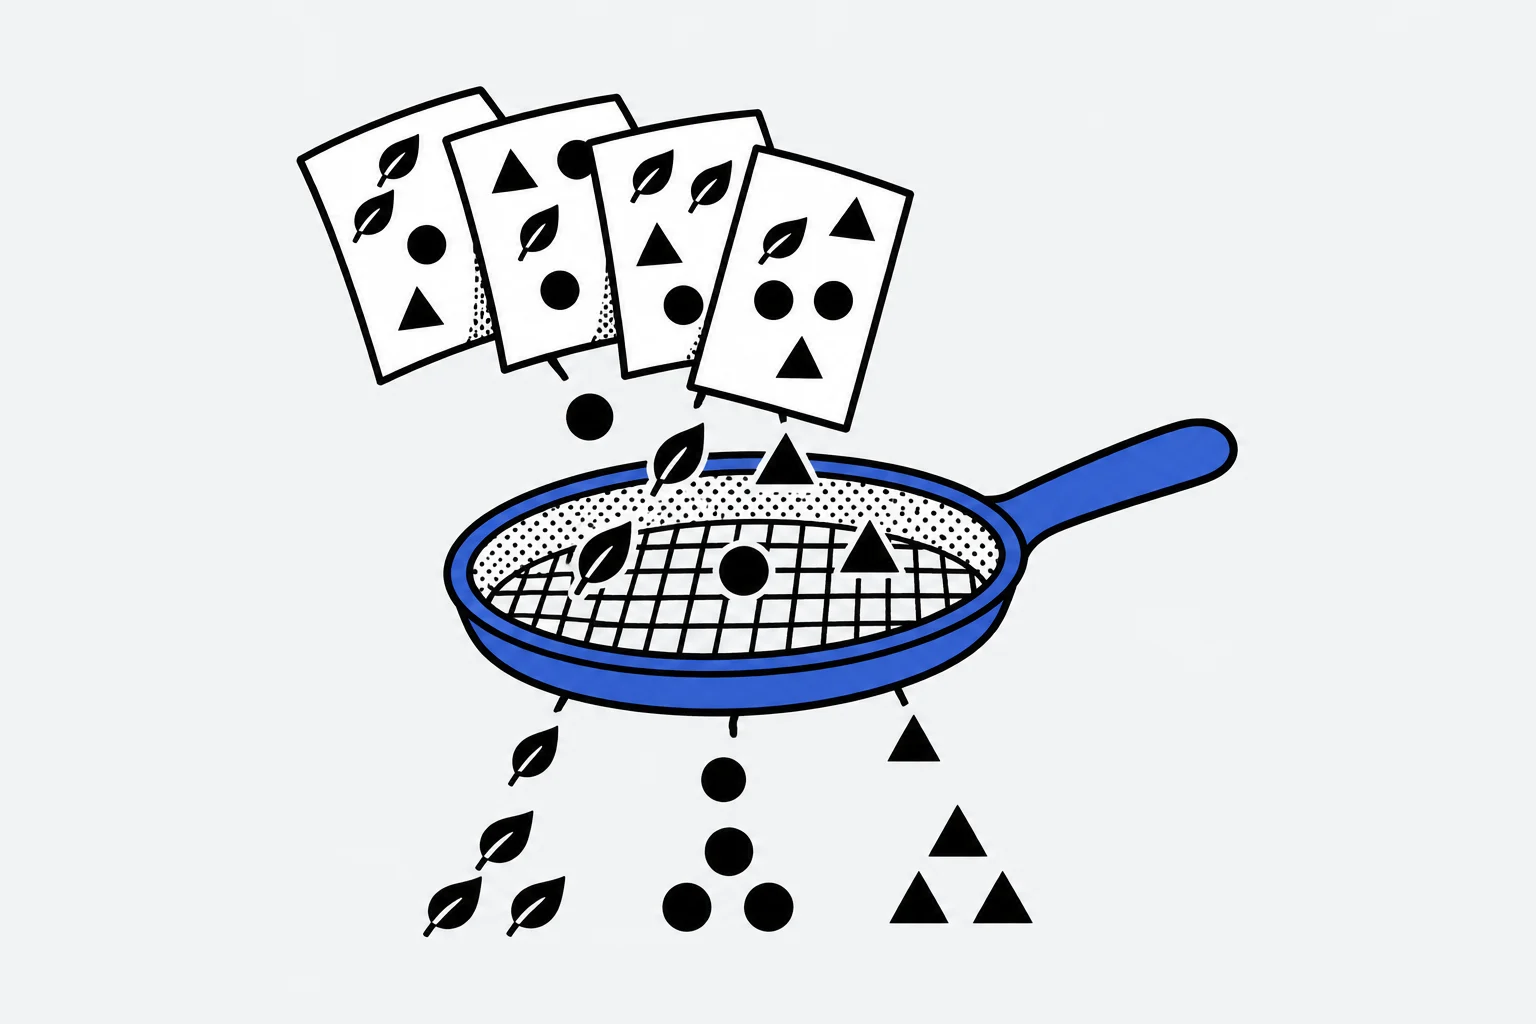
假设你在做一项规划研究,收齐了一百个城市的国土空间总体规划,每份都有几百页。你想知道这些规划都在谈哪些事,哪些城市把生态放在前面,哪些更看重产业。一份份读完要几个月;先定好类目再去编码,又怕漏掉事先没想到的议题。
LDA(latent Dirichlet allocation,潜在狄利克雷分配)主题模型可以先替你读第一遍。它把经常在同一篇文档里一起出现的词归成一组,一组就是一个主题。比如【住房】【保障】【租赁】【公寓】常一起出现,【公交】【轨道】【站点】【换乘】是另一组。它同时算出每篇文档里各个主题占多大比例。举个假设的例子,某市的规划里,住房主题占 40%,交通主题占 35%,生态主题占 25%;另一个市也许交通就占了一半。
它背后的设想是,每篇文档都由几个主题按不同比例混合而成,文档里的每个词都出自其中一个主题。所有文档共用同一套主题,只是比例各不相同。LDA 手里只有看得见的词,它倒推回去,找出最可能写出这批文档的那套主题和比例(Blei,2012)。主题叫什么,程序并不知道,它交出来的是一串词和一组比例,起名字是读的人的事。
从 pLSI 到 LDA,再到社会科学里的用法
更早的 LSA(潜在语义分析,也叫 LSI)用奇异值分解把词和文档组成的大表压缩成少数几个维度。1999 年,Hofmann 提出 pLSI(probabilistic latent semantic indexing,概率潜在语义索引),改用一个统计模型来做这件事。论文说,和用奇异值分解的 LSI 相比,它有扎实的统计基础,是一个真正的生成模型(能说清一批文档可能是怎样产生出来的),在几个测试集上的检索效果比直接匹配词和 LSI 都好出不少(Hofmann,1999)。
2003 年,Blei、Ng 和 Jordan 发表了 LDA。他们认为 pLSI 还不完整,每篇文档的主题比例只是一串数,没有模型说明这串数从哪来。这带来两个麻烦。参数随语料增多而线性增长,容易过拟合(把训练材料里的偶然当成规律);遇到训练集以外的新文档,也不知道怎样给它算概率。LDA 给每篇文档的主题比例也安上一个概率分布,用变分方法(在一族好算的分布里挑出最接近答案的那个)做近似推断,并在文档建模、文本分类和协同过滤上和 pLSI 做了比较(Blei 等,2003)。名字里的狄利克雷分布,就是给出每篇文档主题比例的那个分布;allocation(分配)指按这个比例把文档里的词分给各个主题;latent(潜在)指主题这一层是看不见的(Blei,2012)。
2004 年,Griffiths 和 Steyvers 给 LDA 配了一种马尔可夫链蒙特卡洛算法(靠反复抽样去逼近答案的一类算法),拿它分析《美国国家科学院院刊》(PNAS)的论文摘要,并用贝叶斯模型选择来定主题数。得到的主题和作者给文章标的学科类别相符,他们还提出可以按时间变化找出热门主题(Griffiths 与 Steyvers,2004)。主题数怎么定,另有主题模型评估一篇。
LDA 假定文档的先后无关紧要,Blei 的综述说,分析跨越多年的文集时,这条假定可能不现实。Blei 和 Lafferty 2006 年提出动态主题模型,让主题随时间演变,演示用的是《科学》杂志扫描识别成文字的历年存档(Blei 与 Lafferty,2006)。在这个模型里,一个主题是随时间变化的一串词分布。
2010 年,Hoffman、Bach 和 Blei 提出在线变分贝叶斯算法,能分析海量文集,源源不断送进来的文档也能处理。他们只扫一遍,就在维基百科的 330 万篇文章上训练出 100 个主题,结果和批量变分贝叶斯算法一样好或更好,用时只是后者的一小部分(Hoffman 等,2010)。
2013 年,Grimmer 和 Stewart 给政治学者写了一份自动文本分析的指南。他们说这些方法大大降低了分析大量文本的成本,可是替代不了仔细的思考和细读,而且每个问题都要做大量有针对性的验证(Grimmer 与 Stewart,2013)。
Roberts 等人 2014 年提出结构主题模型(STM),把文档自身的信息放进模型,比如作者的性别、党派,或者在实验里被分到哪一组。他们用它分析问卷开放题和实验中收集的文本,还能估计实验处理的效果(Roberts 等,2014)。Maier 等人 2018 年写道,传播学里用 LDA 的越来越多,它的信度和效度却少有人讨论。他们指出用 LDA 至少要过四道关,还写了一份上手指南(Maier 等,2018),这四道关文本清洗一篇列过。
另一条路是先把每段文字变成语义向量(用一串数表示意思),再聚类,最后给每一类找代表词,Grootendorst 2022 年的 BERTopic 就是这样做的(Grootendorst,2022),见 BERTopic 一篇。
| 年份 | 谁 | 留下了什么 |
|---|---|---|
| 1999 | Hofmann | 用统计模型代替矩阵分解的 pLSI |
| 2003 | Blei、Ng 与 Jordan | 给主题比例也加上概率分布的 LDA |
| 2004 | Griffiths 与 Steyvers | 抽样算法,用 LDA 读一本期刊的摘要 |
| 2006 | Blei 与 Lafferty | 让主题随时间演变 |
| 2010 | Hoffman、Bach 与 Blei | 能分析海量文集的在线算法 |
| 2013 | Grimmer 与 Stewart | 自动文本分析离不开验证 |
| 2014 | Roberts 等 | 把文档信息放进模型的 STM |
| 2018 | Maier 等 | 传播学用 LDA 的四道关 |
| 2022 | Grootendorst | 先聚类再找代表词的 BERTopic |
LDA 只看一篇文档里有哪些词、各出现几次,不管词序,Blei 认为只想找出文本大致的语义结构时,这样做说得过去。主题数得事先告诉它。它对材料讲的是什么一无所知,文档也不用预先标注,得出的东西之所以像主题,是语言本身的统计结构和 LDA 的假定共同作用的结果(Blei,2012)。它靠同一篇文档里的词一起出现来归纳主题,Yan 等人 2013 年指出,把 LDA 直接用在推文和即时消息这样的短文本上可能效果不好,原因是短文档里词的共现太稀疏(Yan 等,2013)。结果也不总是稳的。Agrawal、Fu 和 Menzies 2018 年在软件工程的几批数据上发现,打乱训练文档的顺序就会得出不同的主题,照默认设置跑出的主题很不稳定(Agrawal 等,2018)。删停用词、做词干提取这类预处理对主题的影响,文本清洗一篇讲过。
规划、旅游和新闻研究里的 LDA
Brinkley 和 Stahmer 2021 年收集了加州 461 个城市的总体规划,用 LDA 归纳出 60 个主题,远超州里要求每份规划必备的 8 个篇章。其中四分之一的主题带有地域性,讲住房的主题和其他主题很少重叠。文中举的一个主题,排在前面的词译过来是【资金】【住房】【低收入】【可负担】。他们特意说明,计算机并不知道这组词是什么意思,熟悉总体规划的读者可能会把它叫作【可负担住房】(Brinkley 与 Stahmer,2021)。
LDA 在规划研究里也不只用来读文字。Cui 等人 2020 年把武汉三环以内划成 2451 个 500 米见方的格子,把一种 LDA 的变体用在居民的移动数据上,识别每个格子的城市功能和功能混合的程度。功能识别的准确率是 89.3%,高于 K 均值聚类和 Word2Vec(按上下文学词义的模型)(Cui 等,2020)。
旅游研究拿它读在线点评。Guo、Barnes 和 Jia 2017 年分析了 16 个国家 25670 家酒店的 266544 条点评,LDA 找出 19 个酒店自己能掌控的关键维度,不同人口群体之间也有差别(Guo 等,2017)。
DiMaggio、Nag 和 Blei 2013 年用 LDA 看美国政府资助艺术这件事在报纸上被怎样框定。材料是五家美国报纸 1986 到 1997 年间所有提到政府资助艺术的近 8000 篇文章,这些年里这项资助从没有争议变成了争议焦点。他们讨论了模型的选择和结果的解释,也讲了怎样验证,还把主题模型和其他统计工具结合起来,估计各家报纸使用不同框架的多少(DiMaggio 等,2013)。
想深入可以读这几篇
- Blei(2012)Probabilistic topic models,八页的综述,从一篇文章混合了几个主题讲起,接着讲两类算法和放宽 LDA 假定的各种扩展。
- Blei、Ng 与 Jordan(2003)Latent Dirichlet Allocation,LDA 的出处,引言从 tf-idf 讲到 LSI 和 pLSI,说明各自缺了什么。
- Griffiths 与 Steyvers(2004)Finding scientific topics,用 PNAS 摘要做的示范,可以看到主题和学科类别怎样对应。
- DiMaggio、Nag 与 Blei(2013)Exploiting affinities between topic modeling and the sociological perspective on culture,讲主题模型和文化研究里的框架、多义等概念相通在哪里,也讲怎样验证结果。
- Grimmer 与 Stewart(2013)Text as Data: The Promise and Pitfalls of Automatic Content Analysis Methods for Political Texts,讲自动文本分析能做什么、会在哪里出错,以及怎样验证。
TATOOLS 里的两个 LDA 工具
TATOOLS 的【高级LDA主题模型】对每个文件分别建一套主题,交给它的可以是访谈稿和论文摘要,也可以是问卷开放题或公众号评论。报告列出每个主题的代表词和主题标签,各主题的占比与代表性原文片段,每个片段归入哪个主题,以及主题之间的相似度;交了几个文件时,还会比较各文件的主题有多相似。
【经典LDA主题建模】把所有材料合在一起训练一套主题,材料可以是一批短评,也可以是一部长文。报告列出主题关键词和主题规模,画出主题间距离图,给出每篇文档的主题分布,以及困惑度和主题一致性。