文本聚类:没有分类表,怎样让文本按内容分组
一大批留言、评论或访谈,还没有分类表,能不能先让程序按内容相近分成几组?这篇讲文本怎样变成能比远近的数,层次聚类和 k-means 怎样分组,分出的组怎样起名和验收,以及这套办法的来历、用处和值得读的论文。
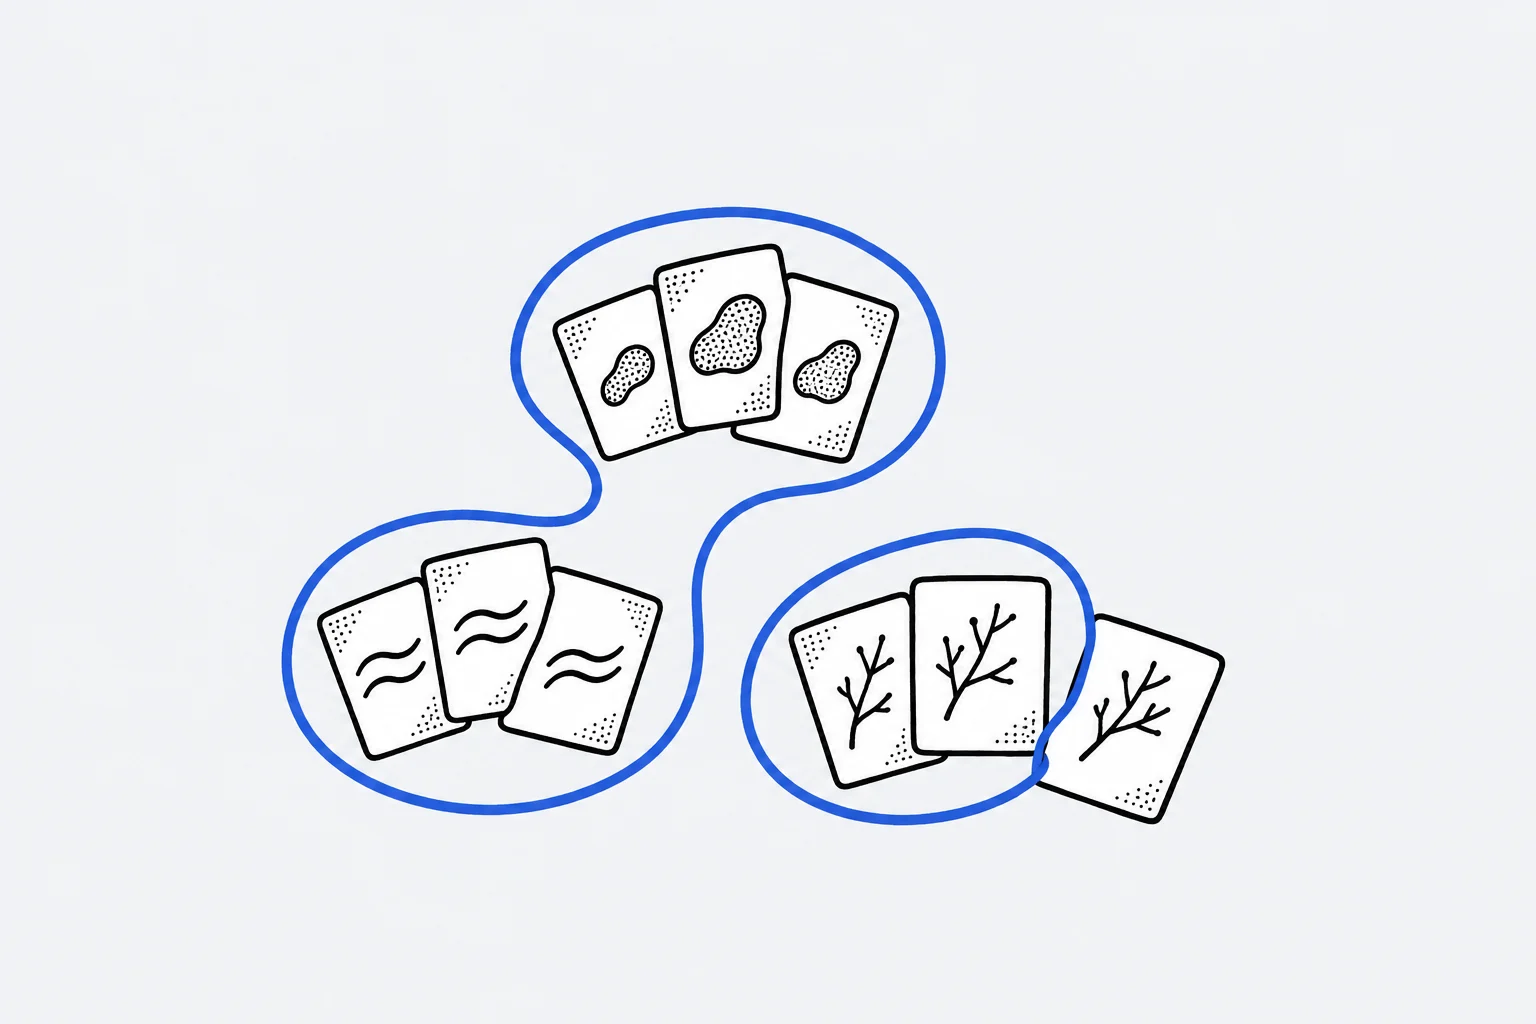
假设一座城市修编总体规划,公开征求意见,收回来两千多条留言。有人说地铁站离小区太远,有人说老街不该拆,还有人只是抱怨停车难。你想先知道大家主要在谈哪几件事,可手上没有现成的分类表,也不想先定好几个类别再把留言往里塞。
文本聚类(document clustering)做的就是这一步。程序事先不知道任何类别,只看每条留言用了哪些词,用词相近的放进同一组,差得远的分开。分出来的组只有编号,组里讲的是什么、该叫什么名字,要你读过之后来定。
程序比的是数,所以每条留言先要变成一串数。常见的做法是把留言拆成词,每个词占一个位置,记下它在这条留言里出现几次,再按 TF-IDF 调整权重,让哪儿都有的词分量轻一些。比较两条留言时,常看这两串数的方向是否一致,这叫余弦相似度(cosine similarity),长评和短评也能放在一起比。
分组的办法主要有两类。层次聚类(hierarchical clustering)先让每条留言自成一组,每次把最相近的两组合成一组,一直合到只剩一组,留下一棵树状图,想要几组,就在树的某个高度横切一刀。k-means(K 均值)要你先说分几组,程序摆出几个中心,把每条留言归到最近的中心,再把中心挪到组内的平均位置,反复几轮,直到分组不再变化。中心怎样一步步挪,见 k-means 一篇。
从检索工具到研究方法
1971 年,Jardine 和 van Rijsbergen 为信息检索提出一类办法,先把文档自动做层次聚类,查的时候按组找。他们用 Cranfield 航空文献集的一个子集检验,表明按组检索可以做到和逐篇匹配一样有效,效率却高得多(Jardine 与 van Rijsbergen,1971)。这靠的是教材里所说的聚类假设,一组里有一篇文档和某次查询相关,同组的其他文档多半也相关(Manning 等,2008)。
要算远近,文档得先成为空间里的点。Salton 等人 1975 年把文档和检索请求放进同一个空间里比较(Salton 等,1975),TF-IDF 一篇讲过。
层次聚类合并两组时,要先定两组之间的距离怎么算。Willett 1988 年回顾了层次聚类用于文献检索的研究,认为全连接法(complete linkage,按两组里最不相像的一对来算距离)检索效果可能最好,只是很难高效地实现(Willett,1988)。
Cutting 等人 1992 年写道,文档聚类在检索界不受待见,一嫌太慢,运行时间常随文档数的平方增长,二嫌对检索帮助不大。他们认为这两条只在拿聚类改进常规检索时才成立,于是把聚类本身当作浏览一大批文档的入口,并给出线性时间的快速聚类算法(Cutting 等,1992)。这套系统叫 Scatter/Gather(分散与聚拢),读者从分好的几组里挑出想看的,合起来再分,直到找到要找的那一小组(Manning 等,2008)。
那时常有人认为,层次聚类分得好,只是慢;k-means 快,分得却差些。Steinbach、Karypis 和 Kumar 2000 年用八个文档集做了比较,发现 k-means 的一个简单变体,每次挑一组一分为二的二分 k-means(bisecting k-means),分得比普通 k-means 好,也不输他们试过的几种层次聚类(Steinbach 等,2000)。
Dhillon 和 Modha 2001 年写道,文档向量通常有几千维,其中 95% 到 99% 的位置是零。他们研究的球面 k-means(spherical k-means)把每组的中心缩放到长度为 1,叫作概念向量(concept vector),这些概念向量很稀疏,集中在少数词上(Dhillon 与 Modha,2001)。
全自动的聚类方法很多,各自优化的目标不同。Grimmer 和 King 2011 年指出,事先没法知道哪一种会给某位研究者分出有用、有启发的结果。他们把各种方法在同一批数据上得到的分法,加上由它们组合出的几百万种分法,排进一个空间,相近的分法挨在一起,让研究者自己浏览挑选(Grimmer 与 King,2011)。
文本变成数,后来有了按句意的办法。Reimers 和 Gurevych 2019 年提到,BERT(一种预训练语言模型)不适合直接拿来做聚类这类无监督的任务。他们提出的 Sentence-BERT 把每个句子变成带着句意的向量,可以直接用余弦相似度比较,在一万个句子里找最相似的一对,耗时从约 65 小时降到约 5 秒(Reimers 与 Gurevych,2019)。句子的语义相似度和 BERTopic 两篇接着讲这条路。
| 年份 | 谁 | 留下了什么 |
|---|---|---|
| 1971 | Jardine 与 van Rijsbergen | 用层次聚类做检索 |
| 1975 | Salton 等 | 把文档放进向量空间比较 |
| 1988 | Willett | 梳理层次聚类在检索里的用法 |
| 1992 | Cutting 等 | Scatter/Gather,用聚类浏览文档 |
| 2000 | Steinbach 等 | 二分 k-means 不输层次聚类 |
| 2001 | Dhillon 与 Modha | 球面 k-means 和概念向量 |
| 2011 | Grimmer 与 King | 让研究者在众多分法里挑 |
| 2019 | Reimers 与 Gurevych | 能直接比远近的句子向量 |
给组起名,常见的做法是列出组中心权重最高的几个词,或者拿离中心最近的那篇文档的标题当名字。Manning 等人的教材提醒,只看组内最常见的词,可能混进【year】(年)和【Tuesday】(星期二)这类在整批文档里都常见的词,拿这一组和其他组比着挑词,可以把它们筛掉,道理和关键性一样。标题读着顺,却可能带偏。教材的例子里有一组讲的是石油,离中心最近的却是一篇讲飓风的新闻,它分到这组只因为飓风影响了油价。
分得好不好,常用的验法有两种。一种只看分组本身。Rousseeuw 1987 年提出轮廓(silhouette),比较每组的紧密程度和它与别组的分离程度,能看出谁稳稳待在组里,谁夹在两组之间,平均轮廓宽度可以用来评估这次分组,也可以拿来挑一个合适的组数(Rousseeuw,1987)。另一种是拿人工分好的类别来对照,Steinbach 等人用的文档集就带着类别。教材提醒,组内紧、组间开的分数高,不一定对你的用途有用。Grimmer 和 King 认为这两种验法都有难处,改用人的判断来检验自己的办法,其中一项是请两位正在分析大批文本的学者两两比较六种分法,看哪种更有信息量。
研究者拿它分过哪些文字
Grimmer 和 King 在同一篇论文里演示了这套办法,从参议员 Frank Lautenberg 的新闻稿里随机取了 200 篇,分组后,政治学家 Mayhew 归纳过的三类活动,邀功、自我宣传和表明立场,在稿子里都找得到,此外还冒出一类,点名挖苦对方政党或其成员,他们叫它党派嘲讽(partisan taunting)。他们随后分析了 2005 到 2007 年参议员们发的全部 64033 篇新闻稿,随机抽 500 篇请三名研究助理人工归类,再用有监督的办法估计全部稿子,其中 27% 属于党派嘲讽,而且选情不激烈的州,参议员更常这样写。
旅游研究里,Höpken、Fuchs 和 Lexhagen 2024 年研究瑞典西南海岸的 Halland 地区,材料是 TripAdvisor 上 24 家酒店的全部评论,共 622 条。他们用基于 k-means 的关键词聚类,按用词把评论里的句子分成组来找话题,再和要人工标注训练数据的分类方法比,准确度相近,还能在事先定好的话题下面分出更细的小话题,搭成一个话题层级(Höpken 等,2024)。
Liu 等人 2026 年做的是医疗服务研究,分析一家互联网医院的患者在线咨询文字,这些提问短、口语化,又零碎。比较几种做法之后,他们选定 TF-IDF 加权的 Word2Vec(从上下文学词义的模型)词向量配 K-means++(k-means 的一种改进)。患者问得最多的是就医流程上的服务问题,从怎样进入问诊、预约,到检查、缴费和诊后服务;提问数量有季节起伏,各类关注所占的比例在研究期内大致稳定(Liu 等,2026)。
想深入可以读这几篇
- Manning、Raghavan 与 Schütze(2008)Introduction to Information Retrieval,信息检索的教材,第 16、17 章讲平面聚类和层次聚类,也讲怎样评估、怎样给组起名。
- Steinbach、Karypis 与 Kumar(2000)A Comparison of Document Clustering Techniques,七页,在同样的文档集上比较层次聚类和两种 k-means。
- Grimmer 与 King(2011)General purpose computer-assisted clustering and conceptualization,讲聚类怎样帮研究者提出新概念,全文免费。
- Grimmer 与 Stewart(2013)Text as Data: The Promise and Pitfalls of Automatic Content Analysis Methods for Political Texts,政治学文本自动分析的导引,提醒这些方法代替不了思考和细读,要针对具体问题验证。
- Cozzolino 与 Ferraro(2022)Document clustering,近年的综述,先讲文档怎样表示和预处理,再逐类评析文本常用的聚类算法。
在 TATOOLS 里给文本聚类
【简单文本聚类】适合一批评论、问卷开放题这样的短文本。报告给出每组的规模、关键词词云和示例文本,列出轮廓系数等三项质量指标,还有一张类间相似度热力图,看哪两组最容易混在一起。
【高级文本聚类】可以交给它政策文件、访谈逐字稿或读者评论。报告给每组一个由关键词拼成的建议簇名,附上占比和代表文本;开了参数敏感性对比,还能看到分类数加减 1 后各组关键词稳不稳。